 佛山一中电脑协会
深度神经网络与进化算法的强化学习框架——以CartPole为案例的探索与优化实践
高二(18)班 姜哲浩
一、基本概念及游戏测试
1、强化学习(Reinforcement Learning, RL)
强化学习是机器学习的一个分支,其核心思想是让智能体(Agent)通过与环境的交互学习最优策略,以最大化累积奖励。它不同于监督学习(需要标注数据)和无监督学习(发现数据内在结构),而是通过“试错”机制在动态环境中进行学习。
2、CartPole(车杆游戏)
CartPole-v1是经典RL测试环境,目标是通过左右移动小车(Cart),使顶端连接的杆子(Pole)尽可能长时间保持直立不倒。CartPole(车杆游戏),模型如图 1所示。为了保证游戏继续,需要满足以下两个条件:杆子倾斜的角度θ,保持在[-12°, 12°]之间,小车移动的位置x,需保持[-2.4, 2.4]范围。
图 1
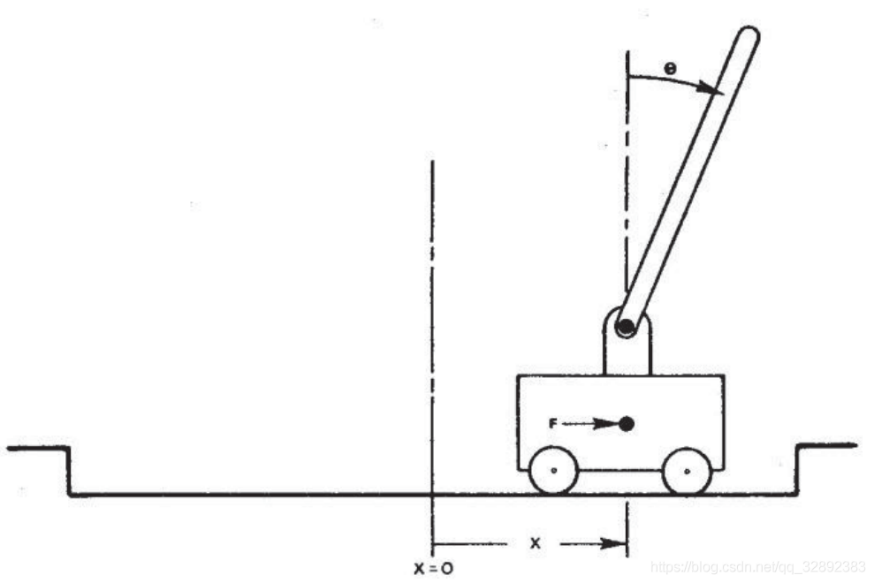
其核心要素包括状态、动作、奖励和策略。
状态空间:小车的水平位置(x)、速度(x˙ )、杆子与竖直方向的夹角(θ)、角速度(θ˙ )。
动作空间:离散动作(向左推/向右推)或连续动作(推力大小)。
终止条件:杆子倾斜超过±12°、小车移动超出±2.4单位范围。
奖励机制:每一步,只要杆子还没有倒下,会得到一个奖励(+1)。如果杆子倒下或者小车移出屏幕(小车的位置超过 +/- 2.4),那么游戏就会结束。(CartPole-v1上限为500步)。
3、强化学习基本流程
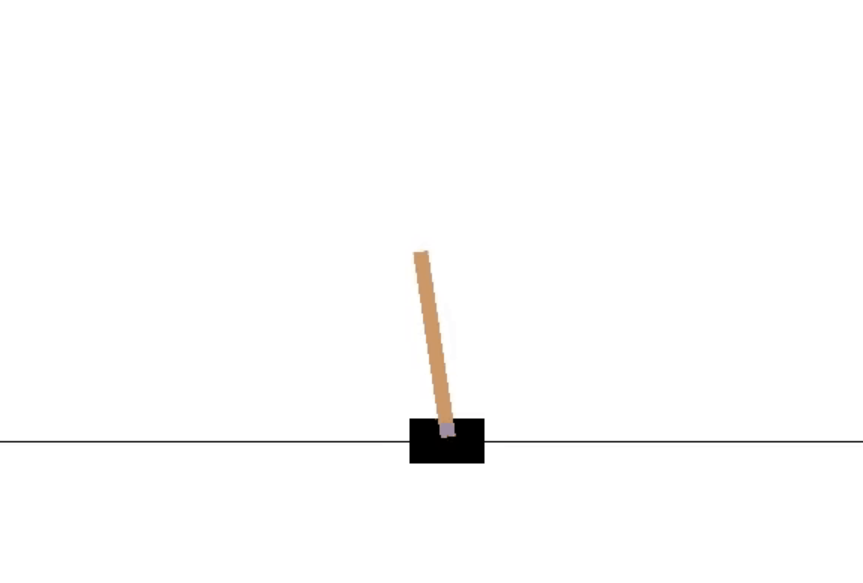
该案例典型地体现了强化学习的基本流程,即"agent-environment loop"。在每个时间点上,智能体(agent,可以认为是你写的算法)选择一个动作(action),环境返回上一次action的观测(Observation)和奖励(Reward),用图 2表示。其游戏进行可视化,如图 3。
图 2 强化学习基本流程
图 3可视化效果
二、存在问题及改进策略
传统方法如Q-learning和策略梯度。常面临探索不足或收敛困难的问题,且传统方法中显存开销极大,训练时往往无法正常使用显卡同时完成一些兼容任务。
为解决上述问题,本项目利用了进化算法的思想。进化算法是一种重计算、少存要求的一种优秀算法,基本思想是优胜劣汰,以一步步迭代出最优解。但是存在优秀个体基因扩散缓慢,因此总体优化过慢的问题。为解决上述问题,结合参考资料及AI辅助,从而提出一种混合架构,结合深度神经网络与进化算法的项目:
1、神经网络架构
设计多分支特征提取网络(含ELU和SiLU激活函数),通过注意力机制动态融合特征,并引入带噪声的线性层(NoisyLinear)增强探索能力。
2、进化算法优化
采用种群进化策略(EvolutionaryExplorer),通过交叉、变异和分层选择优化模型参数,平衡探索与利用。
3、实现过程:
创建200个随机初始化的神经网络
每个个体运行三局游戏取平均
将种群分为三个层级:
Top 30%:直接保留精英
Middle 60%:锦标赛选择
Bottom 20%:随机采样
将不同个体交叉生成新个体并运用自适应变异率适度变异
出现完美个体(500分)时使用完美个体与落后个体进行杂交
4、网络架构
噪声生成采用线性网络生成噪声。
个体网络采用多模态特征融合架构。
两分支分别如下:
| 特性 | Branch1 | Branch2 |
|---|---|---|
| 层级结构 | 256 → 128 | 128 → 128 |
| 激活函数 | ELU | SiLU |
| 数学公式 | f(x) = x(x ≥ 0);α(ex − 1)(x < 0) | f(x) = x · σ(βx) |
| 特征倾向 | 侧重非线性突变特征 | 侧重平滑渐变特征 |
| 计算开销 | 较高 | 较低 |
Branch1(深度特征提取器)
结构公式:
h1(1)=ELU(W1,1x+b1,1)
h2(1)=ELU(W1,2h1(1)+b1,2)
设计特点:
使用ELU激活函数(指数线性单元),在负区间有非零输出,缓解梯度消失
更深的网络结构(256→128)适合捕获高阶状态特征
示例:当小车速度突变时,该分支会输出更强的响应
Branch2(高效特征提取器)
结构公式:
h1(2)=SiLU(W2,1x+b2,1)
h2(2)=SiLU(W2,2h1(2)+b2,2)
设计特点:
使用SiLU激活函数(Sigmoid线性单元),具有自门控特性
紧凑结构(128→128)实现快速特征转换
示例:对杆子角度变化等连续状态更敏感
注意力融合层
动态权重公式:
α=softmax(Tanh(Wa[h2(1);h2(2)]+ba))
融合公式:
hfused=α1h2(1)+α2h2(2)
动态特性:
自动学习不同状态下各分支的重要性权重
示例:当杆子接近垂直时,Branch2的权重会升高
三、策略亮点
1、动态特征融合
基于注意力权重的多分支融合,提升状态表征能力。
2.自适应噪声机制
噪声强度与探索度预测头(explore_head)联动,实现按需探索。
3.分层进化策略
将种群分为精英、中层和底层,通过差异化选择保持多样性,避免早熟收敛。
传统深度强化学习易陷入局部最优,且超参数敏感、显存占用高(超3G),而进化算法收敛缓慢(200代以上)。本项目通过进化算法提供全局搜索能力,结合神经网络的高效表征,旨在解决CartPole中长周期策略的稳定性问题,并为复杂环境下的探索-利用难题提供新思路。
四、训练结果
1.最佳适应度
10代内稳定达到500(环境上限),表明策略完全收敛。
2.平均适应度
从初始约23逐步提升至420以上,进化曲线显示稳定学习过程。
3.种群多样性
方差监测显示,进化后期种群仍保持适度差异,避免同质化。
4. 验证了精英模型的鲁棒性
视频录制结果验证了精英模型的鲁棒性,随机测试中平均奖励达400以上,同时显存占用小于0.4G。
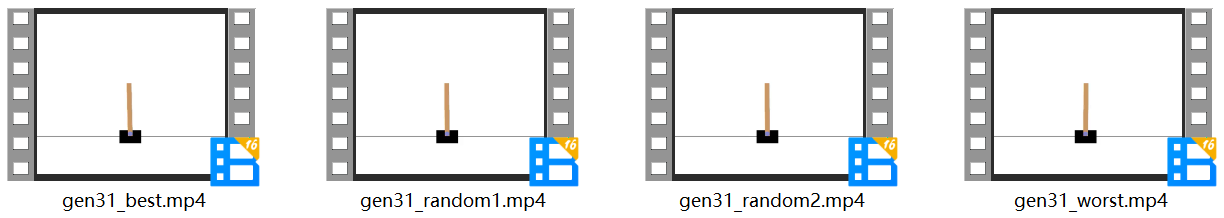
为了展示强化学习的过程,笔者录制了可视化演示见视频,从第八代到第31代,选取了8.9.10,11,12,14,20,21,24,26,27,29,31等13代,每代四个样本测试效果。例如图 4。
图 4 31代四个样本
四、小结
本项目通过算法融合与架构创新,高效解决了CartPole的平衡控制问题,为复杂RL任务提供了可扩展的解决方案。实验表明,该方法在10代内达成环境最大奖励(500步),显存占用降低至0.4G,为复杂环境下的高效探索-利用平衡提供了新范式。作为入门案例,直观展示强化学习的核心概念(状态、动作、奖励循环)。验证新型算法在低维空间的有效性,如探索机制、奖励函数设计、稳定性测试,是算法的试金石。未来可进一步探索多环境泛化能力与更复杂环境空间下的优化。
评论
一起把问题聊明白正在准备评论区…
评论区包含自动审核系统,提交后经审核展示。邮箱仅用于评论通知,不会公开展示。请友善交流,勿在留言中填写敏感信息。