 佛山一中电脑协会
NSF 整理小说、判断对白角色并配置声音,ETT 完成多角色语音生成、片段拼接与混音,把原文连接到可试听、可修改的声音作品。
作者:222 余秋霖
把小说变成多角色音频,需要先判断谁在说话,再为人物安排声音。NSF(Novel Speaker Factory)负责文本与人物资料,ETT 负责语音生成和音频制作,两者连接成一条从原文到声音作品的流程。
先整理内容,再制作声音
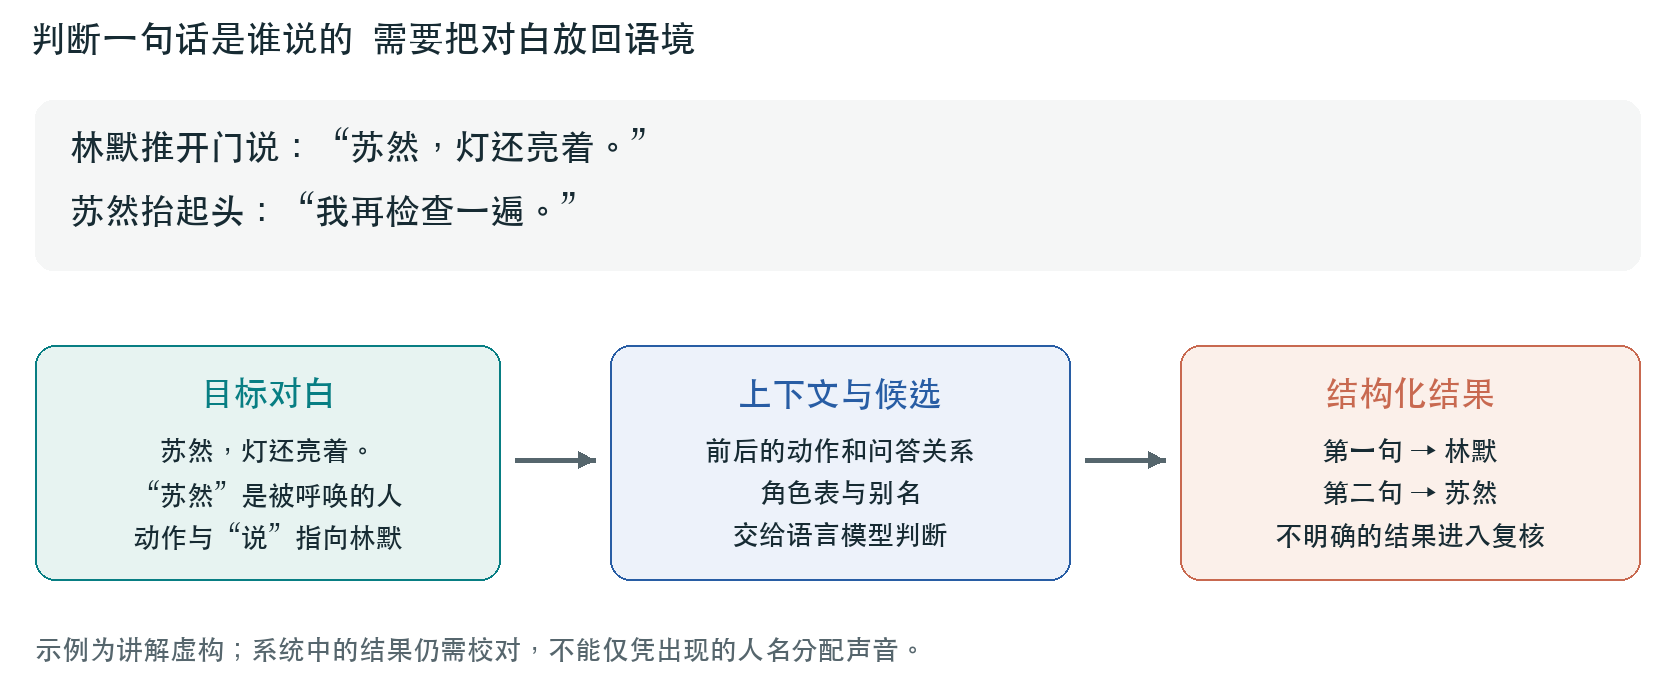
NSF 按章节提取对白,结合前后语境判断说话人,整理角色别名,并生成带角色标记的脚本。识别结果可以人工校对,角色可以修改、合并,再绑定已有音色或通过兼容服务设计声音。
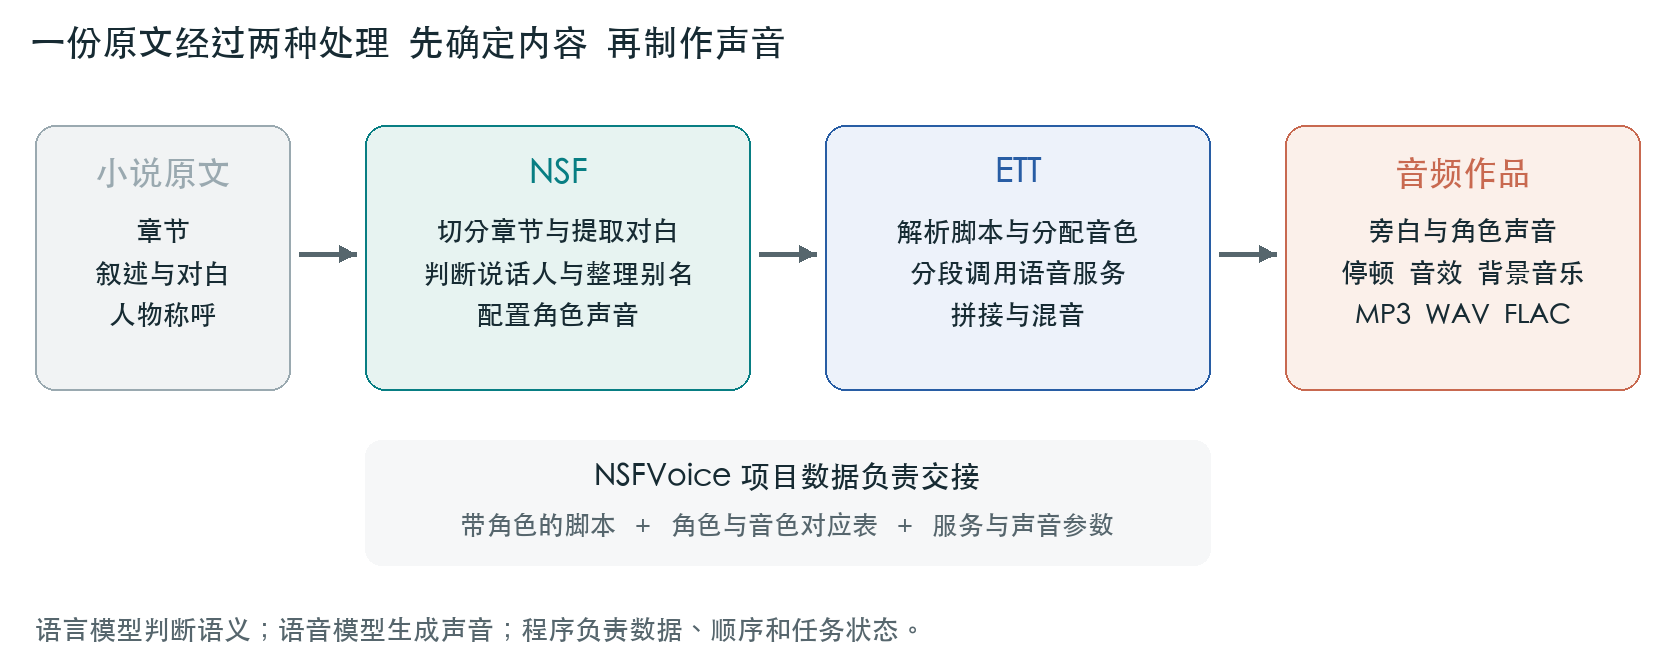
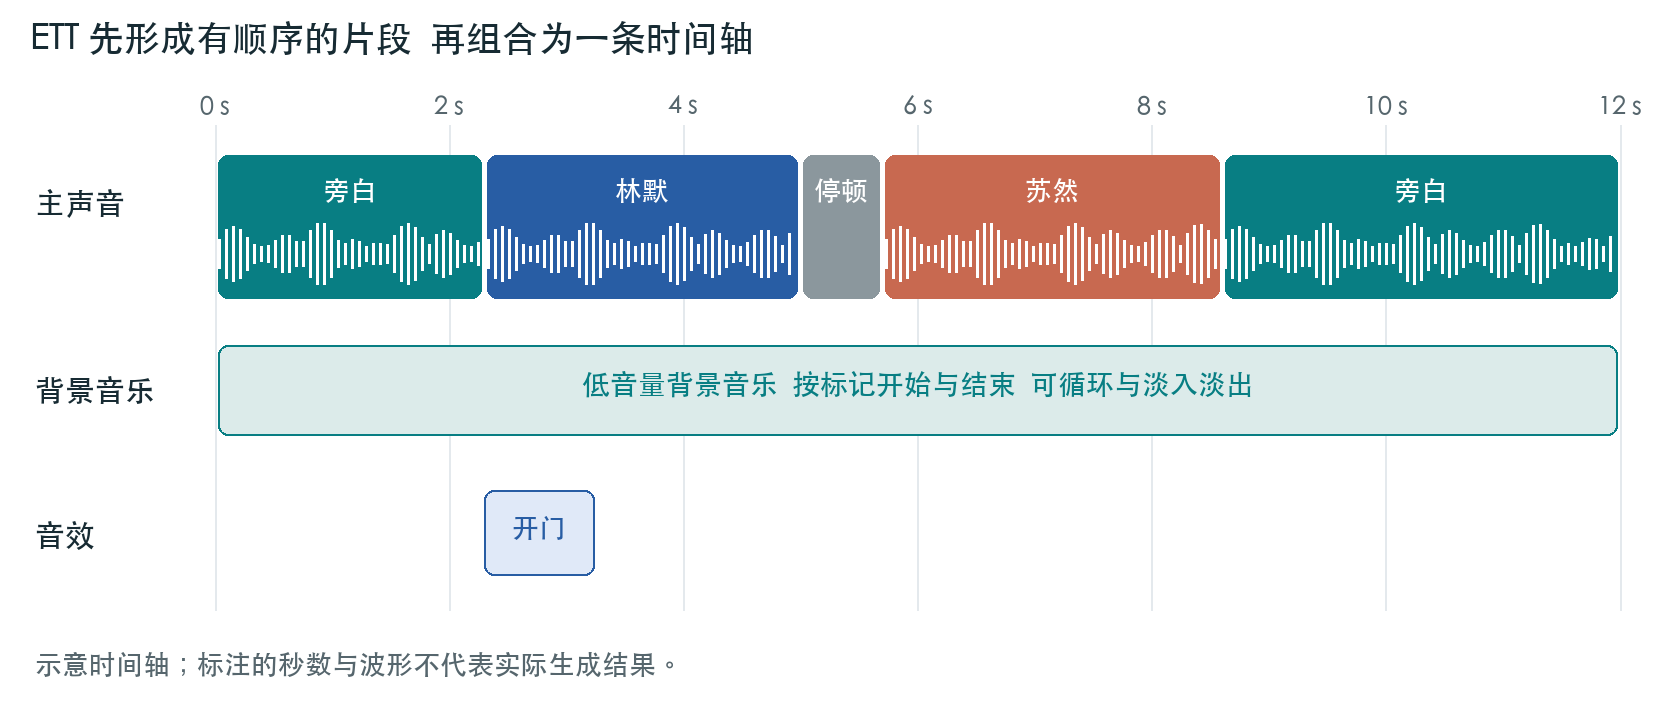
ETT 按角色分配音色,将长文本拆成语音任务。片段可以并发生成,最终仍按脚本顺序排列,再通过 FFmpeg 等能力完成格式转换、拼接与混音。停顿、音乐和音效由明确标记控制,节奏由创作者决定。
可以协作,也能分别使用
两者通过项目数据或本机接口交接脚本、角色与音色对应关系、服务参数和任务进度。ETT 能处理人工准备的脚本,NSF 也能先独立完成小说整理。ETT 还提供 MCP 工具接口,供 AI 助手查询音色、检查脚本和调用生成能力。
长篇任务保留章节标注和音频检查点,在已有结果仍有效时复用已完成部分。说话人判断、音色稳定性和情绪表现仍需校对、试听;使用外部模型或语音服务时,效果和数据处理方式取决于所配置的服务。
ETT 文字转语音工作站曾获创新大赛省二等奖。这份介绍进一步展示它与 NSF 的协作方式。
更多原理见图文手记:ETT 与 NSF,从小说到多角色声音。