 佛山一中电脑协会
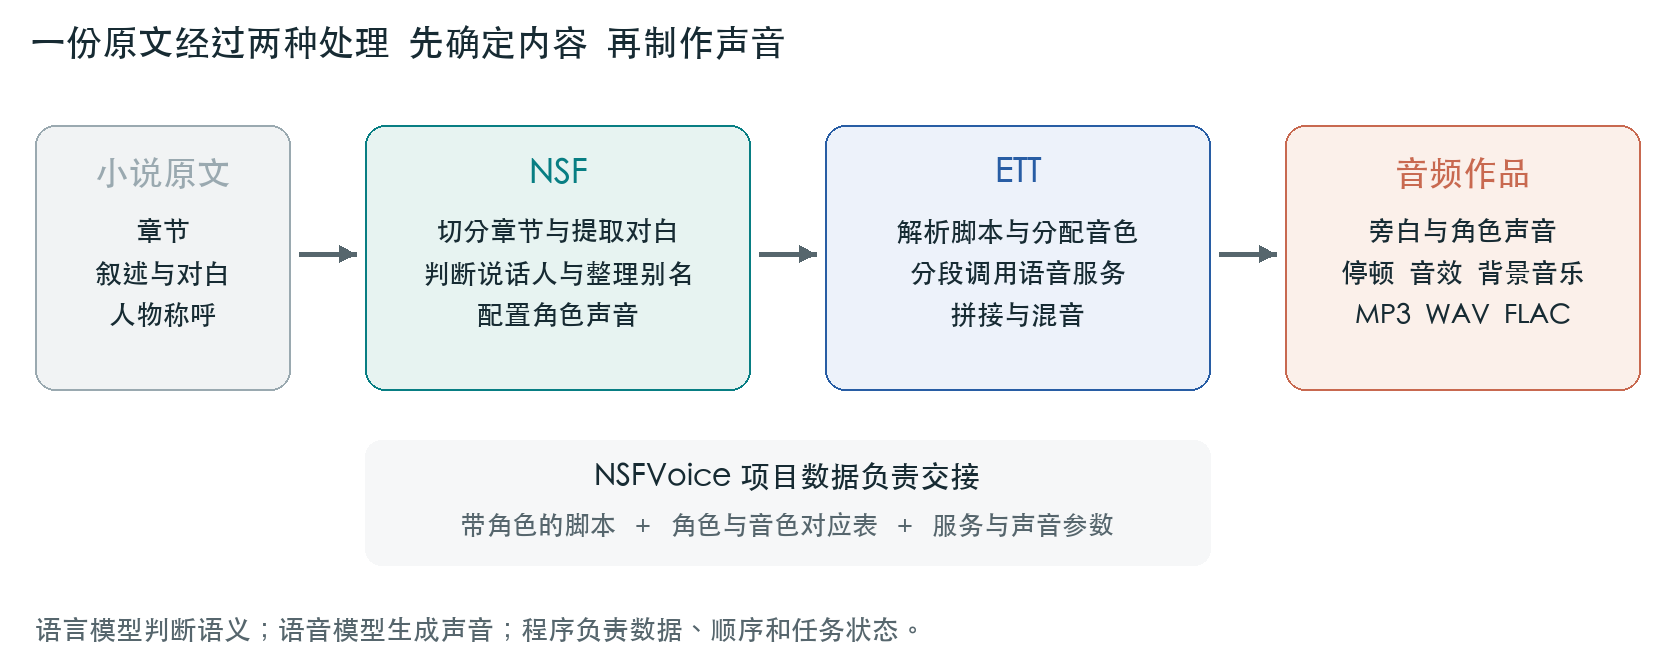
把小说变成多角色音频,要解决两个问题:先判断谁在说话,再让不同人物用各自的声音讲出来。NSF 负责整理文本、识别角色和准备声音资料;ETT 负责语音生成、片段组合与音频输出。两者连接起来,就形成了一条从原文到声音作品的制作流程。
NSF 怎样读懂人物和对白
NSF 是 Novel Speaker Factory 的简称。它先把小说整理为章节,提取对白,再借助大语言模型判断每句话的说话人。
这件事比寻找引号中的人名复杂。例如,林默说“苏然,灯还亮着”,句子里虽然出现了苏然的名字,实际说话人却是林默。判断需要结合动作描写、前后问答和人物称呼。因此,NSF 会把目标对白与附近的原文一起交给模型,并提供可能的角色作为参考。
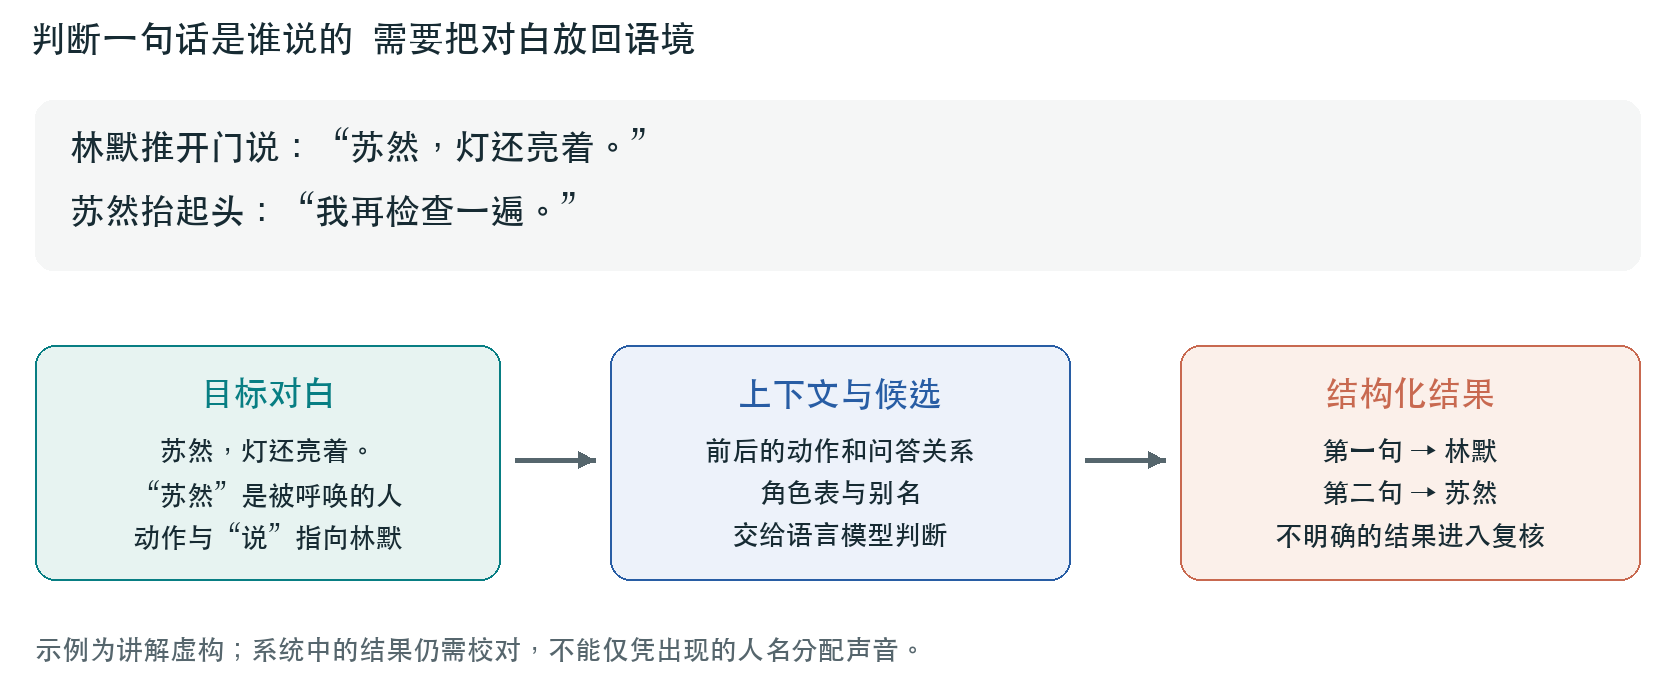
长篇文本会分块、分批处理,避免每次都把整本小说发送给模型。系统还会整理角色的不同称呼,例如把“林默”和“小林”关联起来,减少同一个人被拆成多个角色的情况。识别结果可以人工校对,角色也可以修改或合并。
完成这些工作后,NSF 将人物身份与对白对应起来,同时保留叙述部分,形成带角色标记的配音脚本。
角色怎样获得声音
每个角色可以选择语音服务已有的音色,也可以通过文字描述设计声音,例如“青年男性,音色温暖,语速适中,表达冷静”。
这里有两类模型参与。语言模型可以根据人物的对白与上下文,辅助写出声音描述;语音模型接收描述和试听台词,生成真正可播放的音频。NSF 支持通过 VoiceDesign 兼容服务制作试听,再把选定的音色与角色绑定。
人物身份和声音配置分别保存,所以调整音色时,不必重新判断所有对白。支持参考音频的服务还可以利用声音样本,但具体效果取决于模型与接口;长篇中的音色稳定性和情绪表现仍需试听确认。
ETT 怎样完成音频制作
ETT 是多角色文本转语音工具。它读取脚本,按角色找到对应音色,再把长文本切成较小的语音任务,交给相应服务生成。同一个项目可以组合不同来源的声音。
为了减少等待,部分片段可以并发生成,但最终仍按脚本顺序排列。先返回的片段不会因此被放到故事前面。
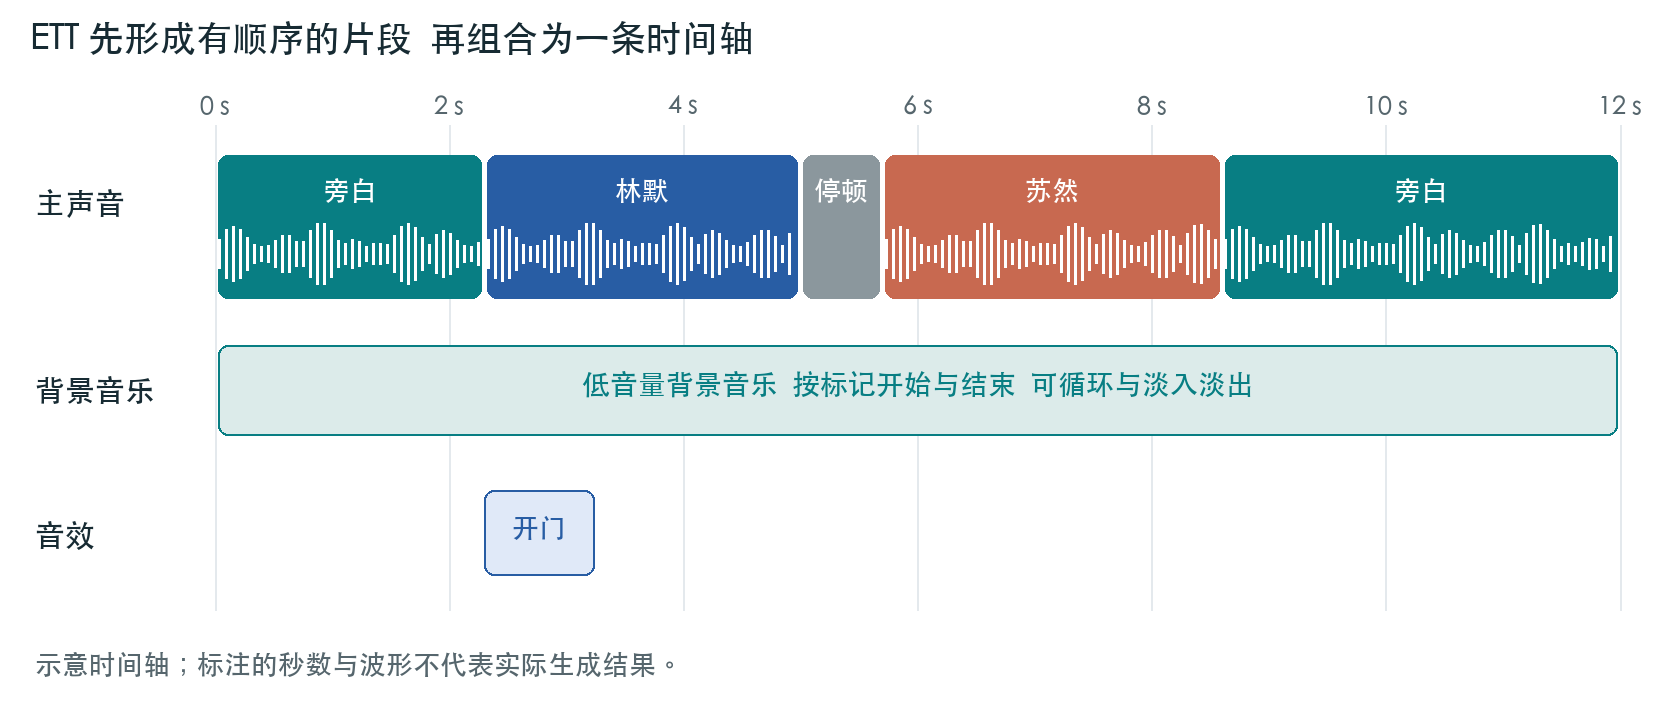
声音生成之后,还要进行音频处理。拼接让旁白和对白依次播放;混音让背景音乐或音效与人声同时出现。ETT 借助 FFmpeg 等音频处理能力,完成格式转换、拼接和混音,并根据实际音频时长安排标记位置。停顿、音乐和音效由明确的脚本标记控制,场景节奏仍由创作者决定。
两个项目如何协作
NSF 通过项目数据交付带角色的脚本、角色与音色的对应关系,以及相关声音参数。ETT 读取这些信息后执行配音。它们也能通过本机接口交换声音列表、提交任务和查询进度。
两者各自可以独立使用:ETT 能处理人工准备的脚本,NSF 能先完成小说整理,之后再交接声音制作。ETT 还提供 MCP 工具接口,让 AI 助手查询音色、检查脚本并调用生成能力。MCP 可以理解为 AI 助手使用外部工具的一套约定。
长篇任务需要考虑中断。NSF 保存章节与标注进度,ETT 为声音片段保留检查点;条件匹配、已有结果仍有效时,可以复用完成部分,补齐剩余工作。
这套组合把文本理解、角色配声和音频处理连接起来,同时保留检查与修改的空间。它的效果仍受原文、模型和语音服务影响:说话人可能判断错误,声音也需要调整。核心价值在于让这些步骤有序衔接,让创作者能把精力放在内容判断和声音表现上。
评论
一起把问题聊明白正在准备评论区…
评论区包含自动审核系统,提交后经审核展示。邮箱仅用于评论通知,不会公开展示。请友善交流,勿在留言中填写敏感信息。